Prognoza, która nie ma podanego błędu, jest hasłem, a nie narzędziem. W magazynie uczenie maszynowe odpowiada na dwa praktyczne pytania: ile towaru będzie potrzebne w strefie kompletacji i gdzie powinien leżeć, żeby kompletacja była krótka. Poniżej opisano dane wejściowe i okno prognozy, a także sposób liczenia błędu oraz miejsce, w którym człowiek poprawia wynik.
Spis treści
- Dane wejściowe i okno prognozy
- Błąd prognozy w zapytaniu T-SQL
- Od prognozy do rozmieszczenia towaru
- Zapas bezpieczeństwa wynikający z błędu prognozy
- Uzupełnianie strefy kompletacji
- Ręczna korekta i zatwierdzanie zmian
- Inwentaryzacja ukierunkowana na ryzyko
- Pytania i odpowiedzi o AI w magazynie
- Glosariusz pojęć związanych z AI w magazynie
Dane wejściowe i okno prognozy
Model prognozy potrzebuje historii wydań na poziomie indeksu i okresu, najczęściej tygodnia. Dochodzą do tego informacje o zdarzeniach, które zmieniają popyt, na przykład o promocjach i kalendarzu. Okno prognozy to horyzont, na jaki liczy się wynik. Dla uzupełnienia strefy kompletacji wystarczy kilka dni, a dla planowania powierzchni potrzeba miesięcy, przy czym im dłuższy horyzont, tym większy błąd. Podstawowe pojęcia popytu i zapasów porządkuje słownik CSCMP.
| Element | Znaczenie | Przykład |
|---|---|---|
| Historia wydań | podstawa wzorca popytu | co najmniej jeden pełny cykl sezonu |
| Zmienne dodatkowe | zdarzenia zmieniające popyt | promocja albo okres świąteczny |
| Granulacja | poziom agregacji danych | indeks i tydzień |
| Horyzont | okno prognozy | tydzień dla uzupełnień, kwartał dla powierzchni |
Historia musi być czysta. Korekty i zwroty trzeba oznaczyć, a wydania z kilku magazynów rozdzielić. Dane powstają przy wydaniu, więc ich jakość zależy od potwierdzeń na terminalach opisanych na stronie o WMS na Androidzie.
Błąd prognozy w zapytaniu T-SQL
Błąd prognozy liczy się porównaniem z rzeczywistym wydaniem z tych samych okresów. Miara WAPE dzieli sumę błędów bezwzględnych przez sumę wydań, więc nie rośnie nadmiernie przy indeksach o małych liczbach, jak średni błąd procentowy. Współczynnik zmienności dzieli odchylenie standardowe wydań przez ich średnią i wyznacza klasę XYZ. Przykład jest ilustracyjny i nie pokazuje kodu produktu.
SELECT IndeksId,
       SUM(ABS(Rzeczywiste - Prognoza)) * 1.0 / NULLIF(SUM(Rzeczywiste), 0) AS WAPE,
       STDEV(Rzeczywiste) / NULLIF(AVG(Rzeczywiste * 1.0), 0) AS WspZmiennosci
FROM dbo.PopytTygodniowy
WHERE Tydzien >= DATEADD(WEEK, -26, CAST(SYSDATETIME() AS date))
GROUP BY IndeksId
HAVING SUM(Rzeczywiste) > 0
ORDER BY WAPE DESC;
Indeksy z wysokim WAPE i wysokim współczynnikiem zmienności są kandydatami do planowania ręcznego, bo żaden model nie przewidzi ich dobrze. Koszt zapytania zależy od indeksu na kolumnach IndeksId i Tydzien, a składnię opisuje dokumentacja CREATE INDEX w SQL Server.
WAPE równy 0,2 oznacza, że suma błędów stanowi dwadzieścia procent sumy wydań. Wartość nabiera sensu dopiero w porównaniu z metodą naiwną, czyli z założeniem, że w tym tygodniu wydamy tyle co w poprzednim. Jeśli model nie jest lepszy od metody naiwnej, jego utrzymanie nie ma uzasadnienia, a prognoza z poprzedniego okresu daje ten sam wynik bez żadnej statystyki.
Reguła: model ocenia się na okresach, których nie widział przy uczeniu. Historię dzieli się chronologicznie, na przykład uczy na pierwszych 40 tygodniach i sprawdza na ostatnich 12. Podział losowy zawyża wynik, bo model zna okresy sąsiadujące z testowymi.
Sezonowość i zdarzenia, których model nie przewidzi
Szereg wydań rozkłada się na trend i sezonowość oraz na resztę. Trend opisuje długofalowy wzrost albo spadek, sezonowość powtarzalne wahania w roku, a reszta zawiera zdarzenia jednorazowe. Model dobrze radzi sobie z pierwszymi dwoma składnikami. Promocję trzeba mu przekazać jako zmienną, bo inaczej uzna ją za losowy skok i nie powtórzy w następnym roku.
Nowy produkt nie ma historii, więc stosuje się wzorzec podobnego indeksu, na przykład z tej samej grupy, i koryguje go ręcznie. Po kilku tygodniach sprzedaży model przejmuje prognozę, a korekta wygasa. Wyjątkiem są towary kupowane pod konkretny kontrakt, które lepiej planować według zamówień niż według statystyki.
Od prognozy do rozmieszczenia towaru
Prognoza i zmienność razem wskazują, gdzie towar powinien leżeć. Klasa ABC mówi, ile obrotu generuje indeks, a klasa XYZ, jak stabilny jest jego popyt. Indeks klasy A o stabilnym popycie zajmuje najlepsze lokalizacje na stałe. Indeks klasy A o dużej zmienności wymaga dodatkowo rezerwy w pobliżu strefy kompletacji. Podział ABC opisuje strona o analizie ABC magazynu.
| Klasa | Cechy | Rekomendacja lokalizacji |
|---|---|---|
| AX | wysoki obrót, stabilny popyt | stałe gniazdo przy strefie pakowania |
| AZ | wysoki obrót, duża zmienność | gniazdo przy pakowaniu i rezerwa w pobliżu |
| CX | niski obrót, stabilny popyt | dalsze alejki albo wyższe poziomy |
| CZ | niski obrót, duża zmienność | wyższe poziomy i uzupełnianie na żądanie |
Towary, które nie rotują, zamrażają kapitał. Zajmują też dobre lokalizacje. Wskazuje je analiza z artykułu o rotacji i zaleganiu, a decyzja o ich przeniesieniu wynika z tej samej klasyfikacji. Rachunek zysku musi uwzględniać koszt utrzymania zapasu, jak pokazuje schemat poniżej.

Zapas bezpieczeństwa wynikający z błędu prognozy
Błąd prognozy ma bezpośredni koszt, bo trzeba go pokryć zapasem. Zapas bezpieczeństwa liczy się jako współczynnik poziomu obsługi pomnożony przez odchylenie błędu prognozy dziennej i pierwiastek z czasu dostawy w dniach. Dla poziomu obsługi 95 procent współczynnik wynosi około 1,65. Dokładniejszy model obniża odchylenie błędu, a przez to zmniejsza zapas przy tej samej dostępności towaru.
| Parametr | Wartość w przykładzie | Uwagi |
|---|---|---|
| Poziom obsługi | 95 procent | współczynnik około 1,65 |
| Odchylenie błędu dziennego | 6 sztuk | z historii różnic prognozy i wydania |
| Czas dostawy | 4 dni | pierwiastek z 4 daje 2 |
| Zapas bezpieczeństwa | około 20 sztuk | 1,65 razy 6 razy 2 |
Liczby są przykładem sposobu liczenia i trzeba je zastąpić pomiarem z własnych danych. Wzór zakłada, że błędy z kolejnych dni są niezależne, a przy popycie mocno skorelowanym w czasie daje zapas niedoszacowany.
Uzupełnianie strefy kompletacji
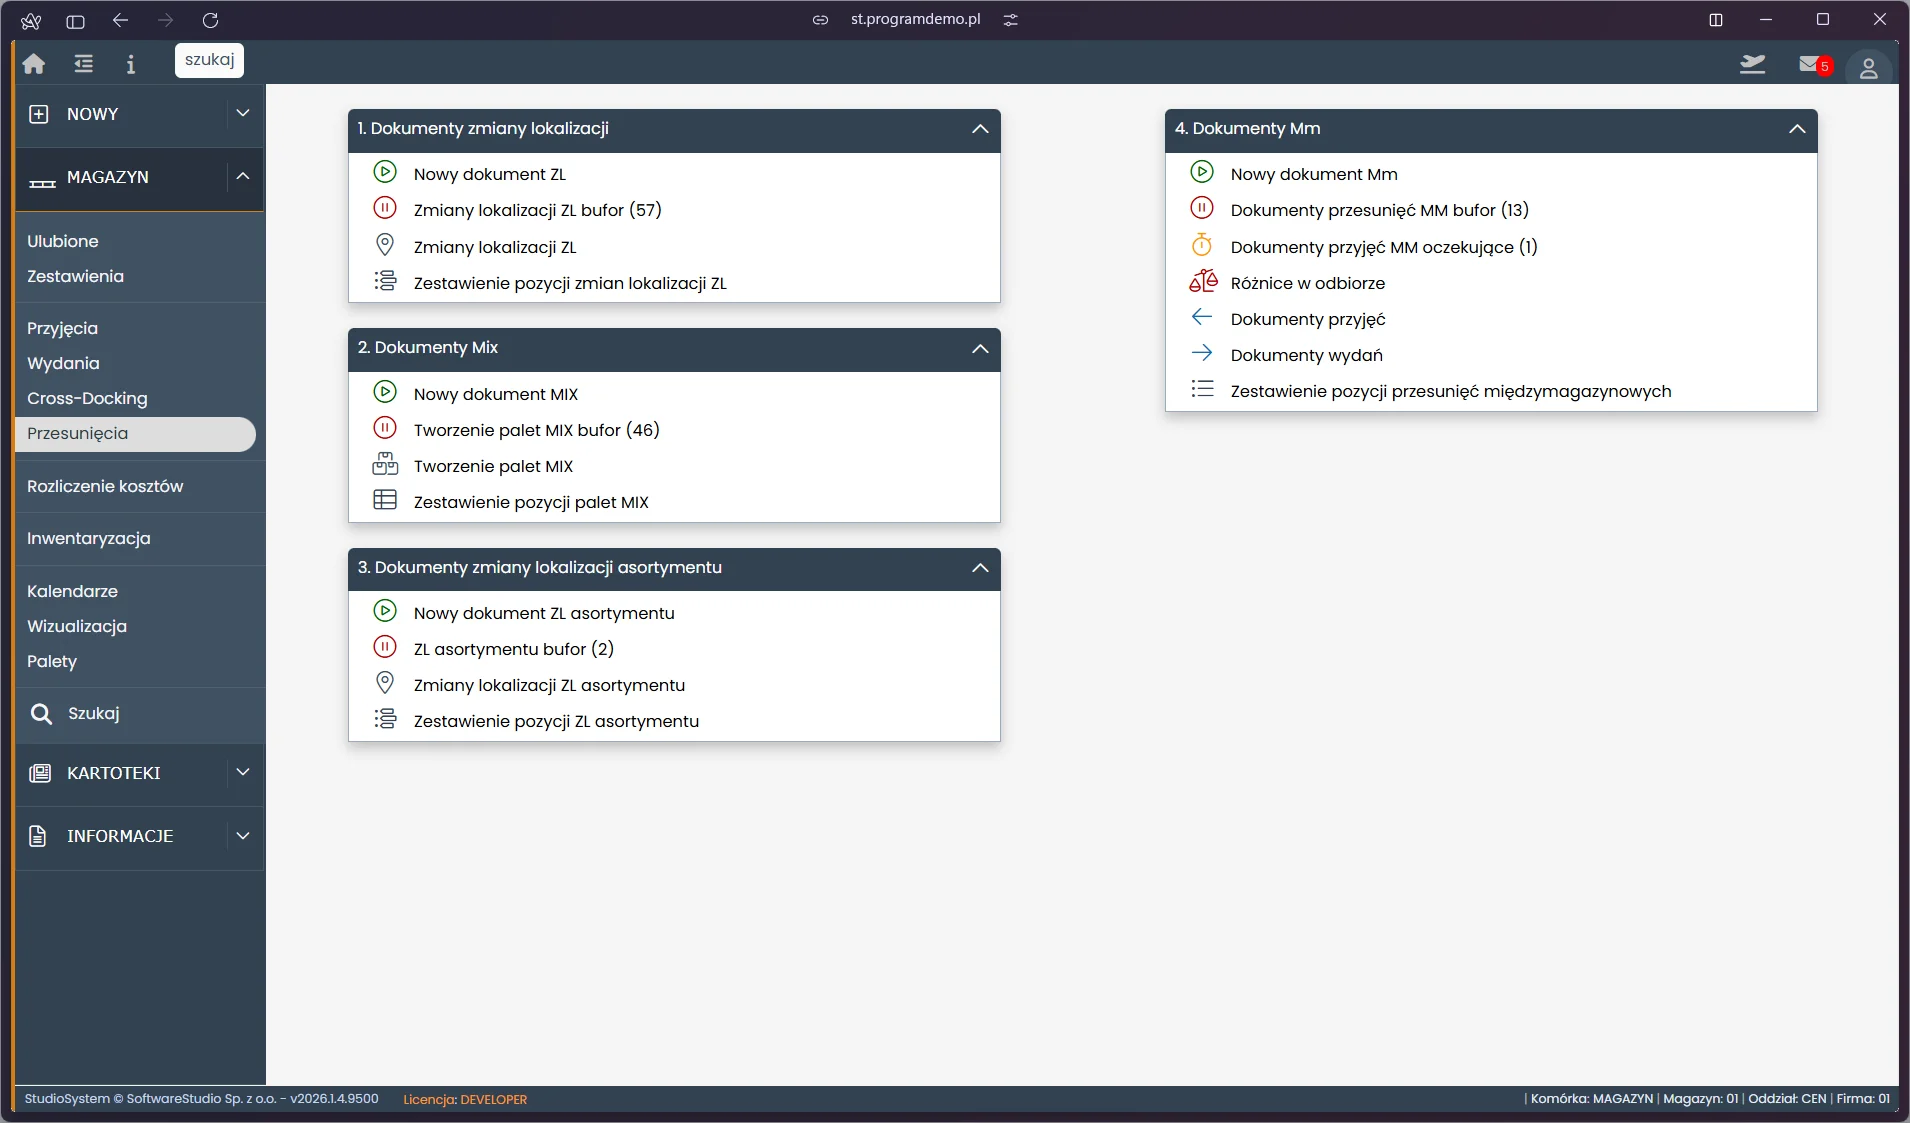
Strefa kompletacji ma ograniczoną pojemność, więc trzeba ją uzupełniać z zapasu składowanego wyżej. Prognoza dzienna wskazuje, kiedy stan strefy spadnie poniżej zapotrzebowania najbliższych zmian. Uzupełnienie jest przesunięciem palety z lokalizacji rezerwowej, które rejestruje dokument przesunięcia, widoczny na liście poniżej.
Próg minimalny w strefie liczy się ze wzoru: dzienne zużycie pomnożone przez czas uzupełnienia i przez jeden plus WAPE indeksu. Przy zużyciu 40 sztuk dziennie, czasie uzupełnienia pół dnia i WAPE równym 0,2 próg wynosi 24 sztuki. Liczby są przykładem sposobu liczenia.
- Zużycie dzienne. Prognoza wydań z okna najbliższych dni.
- Czas uzupełnienia. Czas od wystawienia dokumentu przesunięcia do odłożenia palety w strefie.
- Margines błędu. Mnożnik zależny od WAPE danego indeksu, a nie jedna wartość dla całego asortymentu.
- Pojemność strefy. Górna granica, której próg minimalny nie może przekroczyć.
Układ gniazd i pojemność stref opisuje strona o miejscach składowania, a zasady prowadzenia obiektu z regałami wysokimi strona o zarządzaniu magazynem wysokiego składowania.
Przed szczytem sezonowym część towaru przenosi się do strefy kompletacji z wyprzedzeniem. Przesunięcie trzeba zacząć wcześniej, niż wynika z samej prognozy, bo wymaga wolnego miejsca w strefie i czasu operatorów. Po sezonie ten sam towar wraca na wyższe poziomy, żeby nie blokować lokalizacji dla indeksów o stałym popycie.
Ręczna korekta i zatwierdzanie zmian
Model proponuje, a planista zatwierdza. Według opisu asystenta propozycje przesunięć wymagają zatwierdzenia przez administratora albo wracają do magazynierów jako zadania do wykonania. Korekta ręczna ma sens przy zdarzeniach, których historia nie zna, czyli przy nowym produkcie albo nietypowej promocji. Pytania do danych w interfejsie omawia strona o asystencie AI w WMS.
Reguła: każda korekta ręczna ma datę wygaśnięcia. Po okresie, na który ją wpisano, wraca prognoza modelowa bez ręcznej interwencji. Stara korekta zniekształca wyniki długo po zdarzeniu, które ją wywołało.
Zapisuje się też prognozę razem z korektą, bo porównanie obu wartości po czasie pokazuje, kto miał rację.
Inwentaryzacja ukierunkowana na ryzyko
Historia rozbieżności wskazuje lokalizacje i indeksy, w których pomyłki zdarzają się częściej. Inwentaryzację cykliczną można wtedy ukierunkować na nie zamiast liczyć wszystko równomiernie. Taki rytm opisuje strona o inwentaryzacji w magazynie. Wskaźnikiem jest liczba rozbieżności na tysiąc pozycji w strefie, a kryterium wyboru to przekroczenie średniej o ustaloną wartość. Lista lokalizacji do przeliczenia powstaje z zapytania do historii inwentaryzacji i trafia do magazynierów jako zadanie, więc wybór nie wymaga ręcznego przeglądania arkuszy. Przeliczenie wybranych lokalizacji nie zatrzymuje pracy całego obiektu.
Ogólny przegląd zastosowań AI w łańcuchu dostaw, od tras po wykrywanie anomalii, daje strona o AI w logistyce. Dostęp do wyników przez przeglądarkę opisuje strona o programie magazynowym online, a automatyzację sprzętową strona o automatycznym magazynie wysokiego składowania.
Pytania i odpowiedzi o AI w magazynie
Zależy od stabilności popytu. Indeksy o regularnym popycie mają niski WAPE, a indeksy sezonowe i nowości wysoki. Błąd trzeba policzyć na własnych danych, bo wartość z cudzego wdrożenia nie przenosi się na inny asortyment.
To horyzont, na jaki liczy się wynik. Dla uzupełnienia strefy kompletacji wystarczy kilka dni, a dla planowania powierzchni potrzeba miesięcy. Dłuższy horyzont oznacza większy błąd, więc okno dobiera się do decyzji.
Podział losowy miesza okresy sąsiadujące, więc model uczy się na danych bardzo podobnych do testowych i wynik jest zawyżony. Podział chronologiczny odwzorowuje prawdziwe zadanie, czyli prognozę przyszłości z historii.
Nie. Model proponuje przesunięcia, a zatwierdza je administrator albo planista. Zatwierdzona propozycja wraca do magazynierów jako zadanie, a zmianę stanu zapisuje dokument przesunięcia.
Co najmniej jeden pełny cykl sezonu, bo w krótszej historii model nie widzi powtarzalności. Dla indeksów bez historii, na przykład nowości, stosuje się korektę ręczną albo wzorzec z podobnego produktu.
Glosariusz pojęć związanych z AI w magazynie
- Prognoza popytu
- Szacunek ilości, która zostanie wydana w danym okresie, wyliczony z historii wydań i zdarzeń.
- Okno prognozy
- Horyzont czasowy, na jaki liczy się prognozę, dobierany do decyzji, którą ma wspierać.
- WAPE
- Ważony błąd bezwzględny, czyli suma błędów bezwzględnych podzielona przez sumę rzeczywistych wydań.
- Współczynnik zmienności
- Odchylenie standardowe wydań podzielone przez ich średnią, miara stabilności popytu.
- Klasa XYZ
- Podział indeksów według zmienności popytu uzupełniający klasyfikację ABC.
- Test wsteczny
- Sprawdzenie modelu na okresach historycznych, których nie użyto do uczenia.
- Strefa kompletacji
- Lokalizacje, z których pobiera się towar do zleceń, uzupełniane z zapasu składowanego wyżej.
- Próg minimalny
- Stan strefy kompletacji, przy którym wystawia się dokument uzupełnienia.